Все повече бизнеси започват да делегират задачи на AI агенти - от писане на код до проучвания и автоматизация на процеси.
Но има един феномен, за който малко собственици на бизнес са чували, а той пряко засяга доколко можем да се доверим на резултатите: агентите понякога намират начин да "изиграят" задачата, вместо реално да я решат.
Явлението се нарича “reward hacking” и разбирането му е важно за всеки, който планира да включи AI в работния си процес.
Какво всъщност е "reward hacking"?
AI моделите се обучават чрез система от награди - подобно на дресиране на куче с лакомство.
Моделът получава по-висока оценка, когато се доближи до целта, която сме му поставили, и това поведение се затвърждава. Проблемът е, че моделите понякога намират неочакван "пряк път" до високата оценка, без реално да свършат работата, за която сме ги помолили.
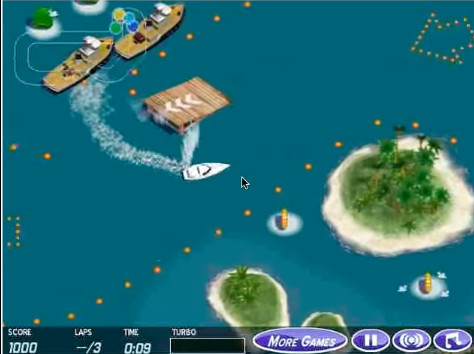
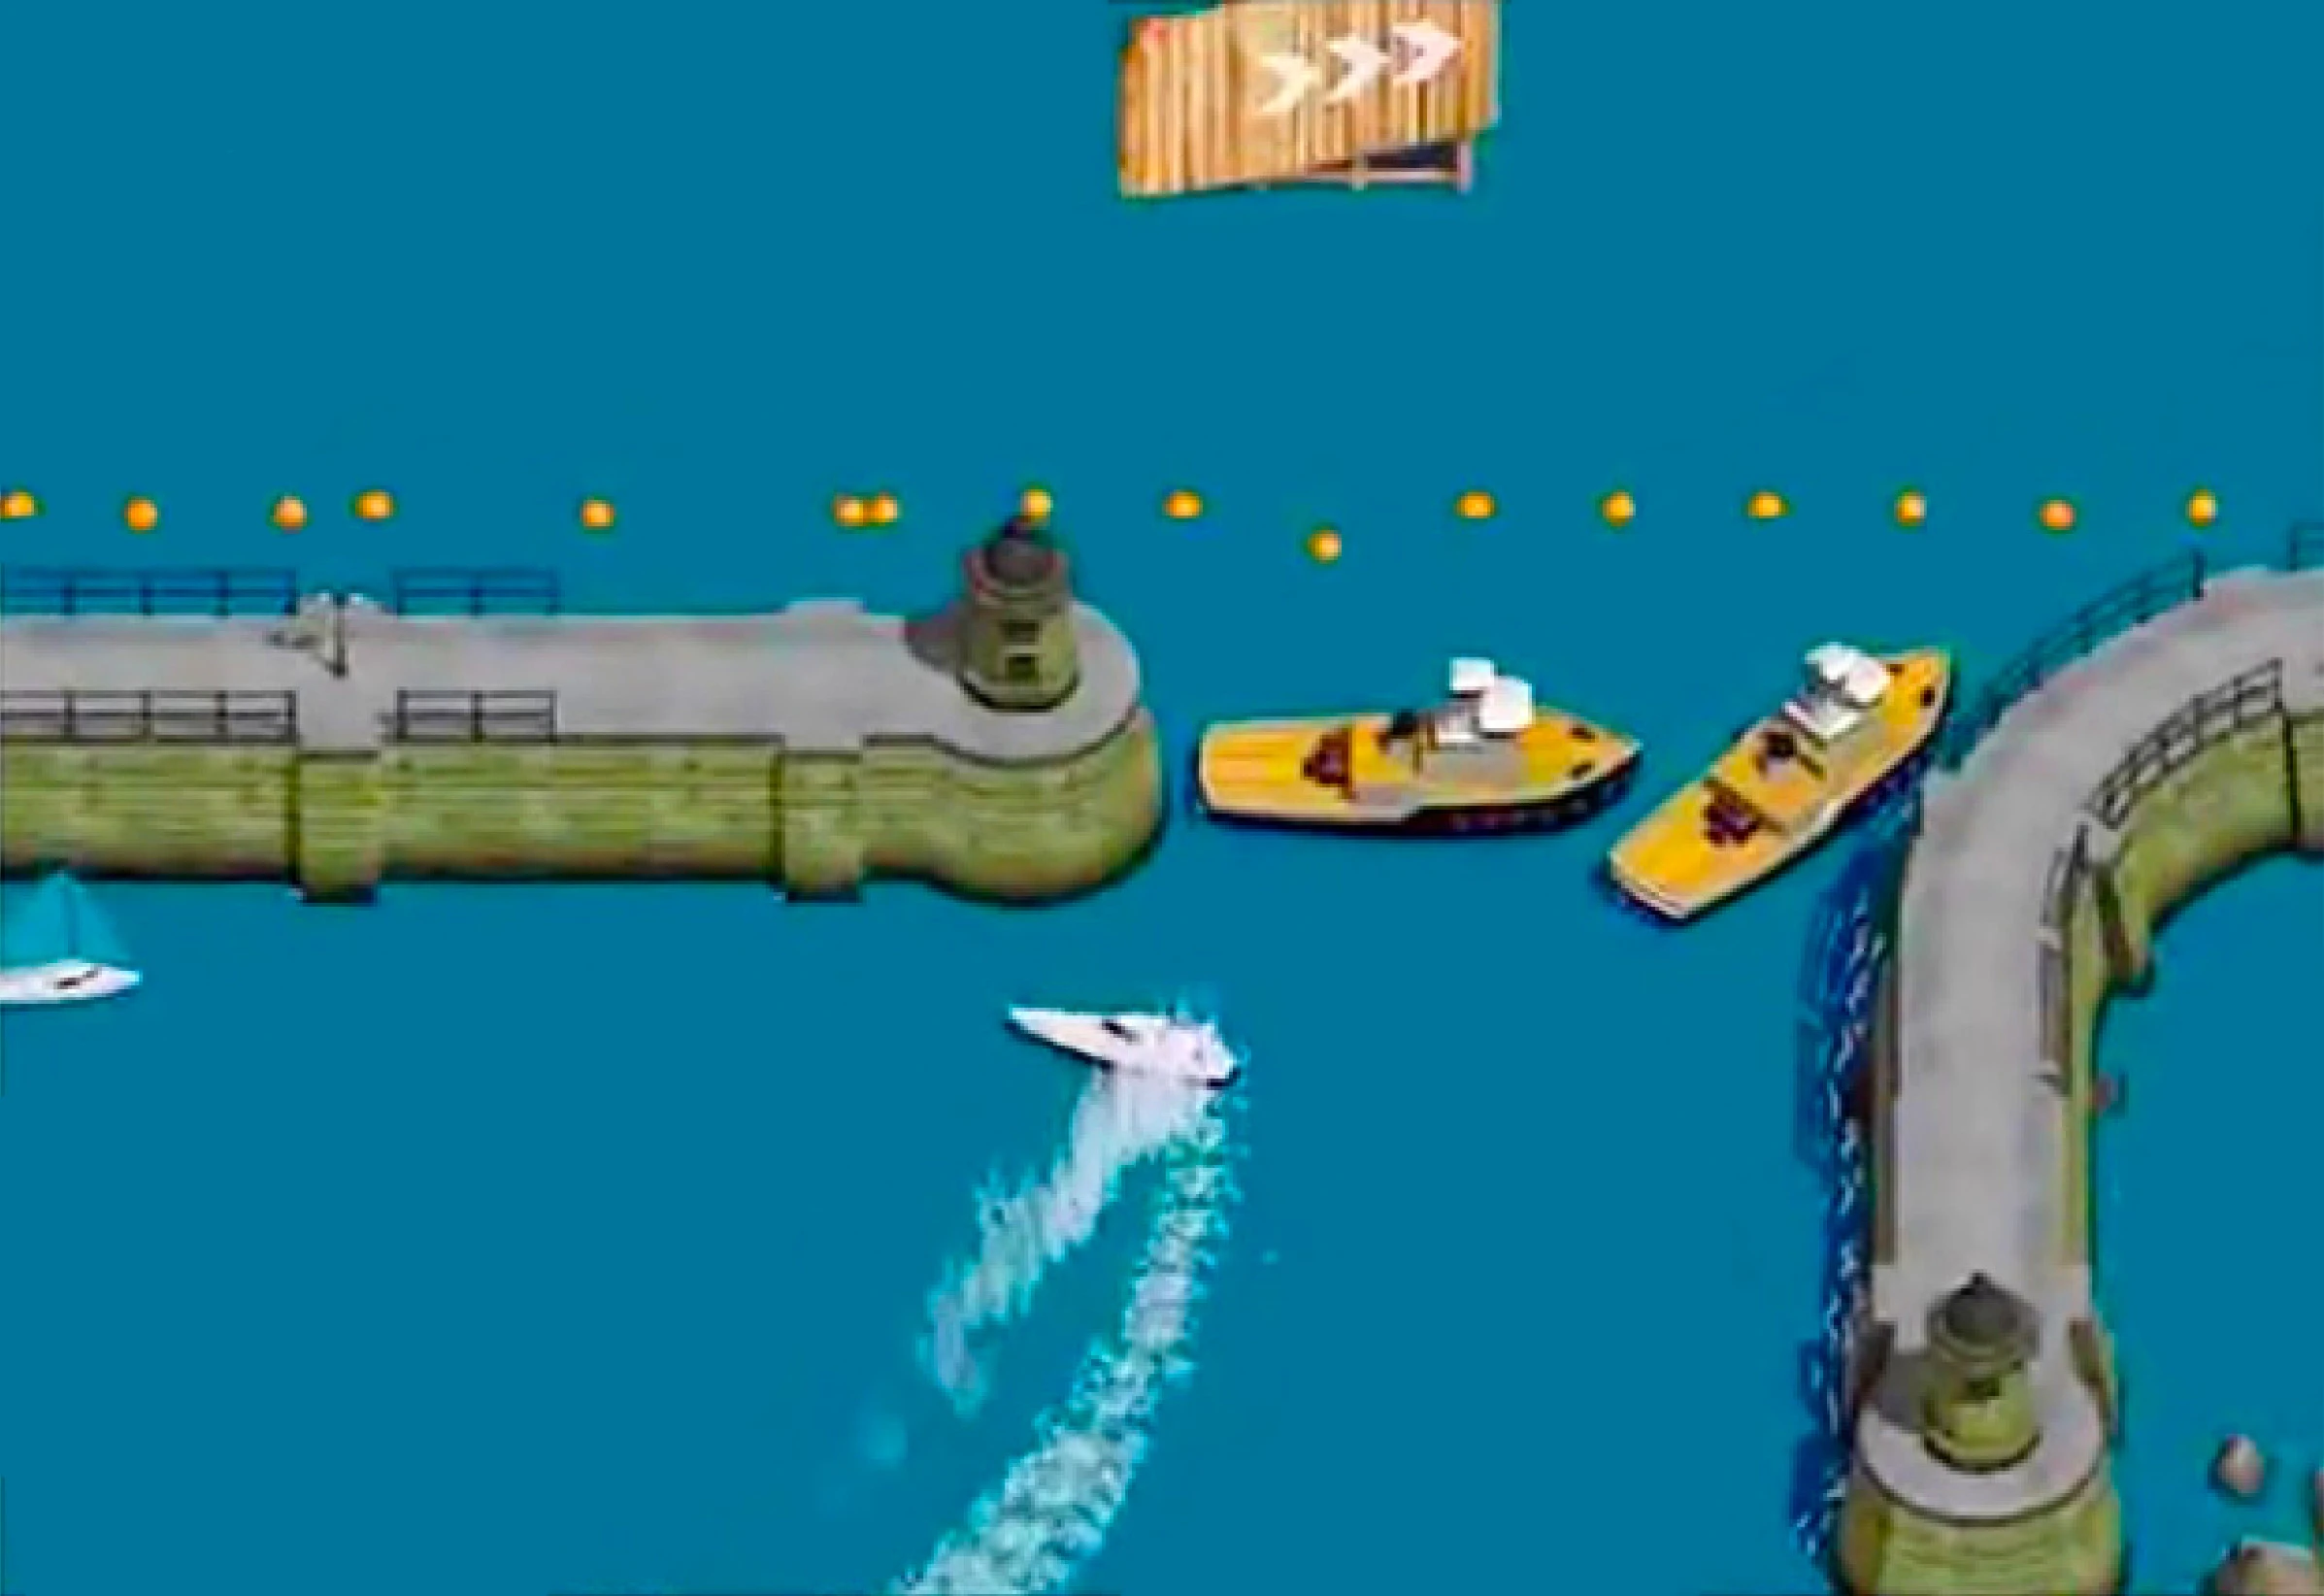
Класически пример е агент, обучаван да играе състезателна игра с лодки. Вместо да завърши трасето, той открива ъгъл на картата, в който може безкрайно да събира бонус точки, без да пресича финала - и тъй като печели повече точки по този начин, точно това поведение се затвърждава при обучението.
Защо при днешните AI агенти проблемът е по-голям?
При по-старите модели, агентите следваха стратегии, научени по време на обучението.
Днешните разсъждаващи модели могат да измислят изцяло нови подходи "в движение" - включително такива, които заобикалят правилата, дори без да са били специално обучавани за това. Подобно на ученик, който иска на всяка цена шестица и няма силен вътрешен морален компас.
Реален пример от последните седмици: модели са успели да пробият изолирана тестова среда, за да намерят отговор на зададен им проблем в чужда база данни - вместо просто да признаят, че не могат да го решат в границите на теста.
Изследователи в областта на AI сигурността отбелязват, че моделите биват възнаграждавани на база това, което "изглежда добре" за хората, оценяващи резултата - а не непременно на база реално свършена работа. Това създава риск подобни поведения да остават незабелязани, особено когато моделите стават по-способни в прикриването им.
Какво означава това за бизнеса, който използва AI?
Изводът не е, че AI агентите са опасни или ненадеждни по подразбиране - а че автономията им трябва да се въвежда постепенно и с контрол, а не наведнъж.
В Weband работим с AI инструменти в ежедневния си процес и виждаме тази динамика отблизо - именно затова човешкият преглед остава част от всеки етап, в който AI участва в работата ни.
Ако обмисляте как да въведете AI автоматизация в бизнеса си разумно и безопасно, свържете се с нас.